Extensions & dépannage
Je veux que l'audio du dialogue passe par Wwise plutôt que par les sons intégrés d'Unreal
Ajoutez l'extension optionnelle LibrettoWwise et pointez les deux points d'extension audio de
Libretto vers ses classes Wwise — la génération produit alors de l'audio adossé à Wwise à la place
des assets Unreal USoundBase. Rien d'autre ne change dans le pipeline.
- Obtenez et activez le plugin. LibrettoWwise est livré à part du plugin principal et n'est pas sur Fab (il tire une dépendance dure au plugin Audiokinetic Wwise) — demandez sur Discord. Activez-le à côté du plugin Wwise, et connectez Unreal à Wwise (le panneau Wwise Browser ; cochez Auto Connect to WAAPI pour reconnecter au démarrage).
- Échangez les deux classes. Dans Project Settings ▸ Libretto, réglez
AudioAssetClasssurULBRWwiseAudioAsset; dans Project Settings ▸ Libretto – Sequence Generator, remplacez le générateur de piste audio par défaut parULBRWwiseTrackGenerator. - Réglez les racines Wwise. Dans les réglages Libretto – Wwise, renseignez les chemins racine
d'import/d'événement (TTS vs voix finale) et la langue d'import. La génération importe alors chaque
réplique comme un Sound Voice Wwise et pose automatiquement son événement
<VX_…>_Play.
Piège
Wwise doit être lancé et connecté via WAAPI chaque fois que vous générez — l'import de voix comme les requêtes de durée de son passent par lui. Si une génération adossée à Wwise signale de l'audio manquant ou des répliques de longueur zéro, vérifiez la connexion du Wwise Browser en premier, avant toute autre chose.
Voir aussi : Intégration Wwise (LibrettoWwise) · Activer LibrettoWwise
Je veux générer une piste Sequencer que Libretto ne livre pas
La génération exécute une liste ouverte de track generators — écrivez le vôtre en dérivant de
ULBRTrackGenerator, et il rejoint le pipeline à égalité avec les pistes d'animation, d'audio, de
caméra et de sous-titres intégrées. Chaque hook est un BlueprintNativeEvent, donc vous pouvez le
faire en Blueprint ou en C++.
- Créez la classe dérivant de
ULBRTrackGenerator, et donnez à votre piste un leaf tag sousLibretto.Generation.Tracksrenvoyé parGetTrackID— c'est ce qui permet de l'activer seule dans l'assistant Generate Sequences. - Surchargez les hooks nécessaires : au minimum
InitSequence(créer votre piste Sequencer),CleanSequence(retirer votre piste précédente pour qu'elle puisse être reconstruite) etPopulateSequenceForLine(la remplir réplique par réplique depuis leSentenceDatapartagé). La référence la plus simple estLBRSubtitleTrackGenerator, qui surcharge exactement celles-ci. -
Enregistrez-la dans Project Settings ▸ Libretto – Sequence Generator ▸ Track Generators. Elle apparaît alors dans la liste Tracks to Generate de l'assistant.
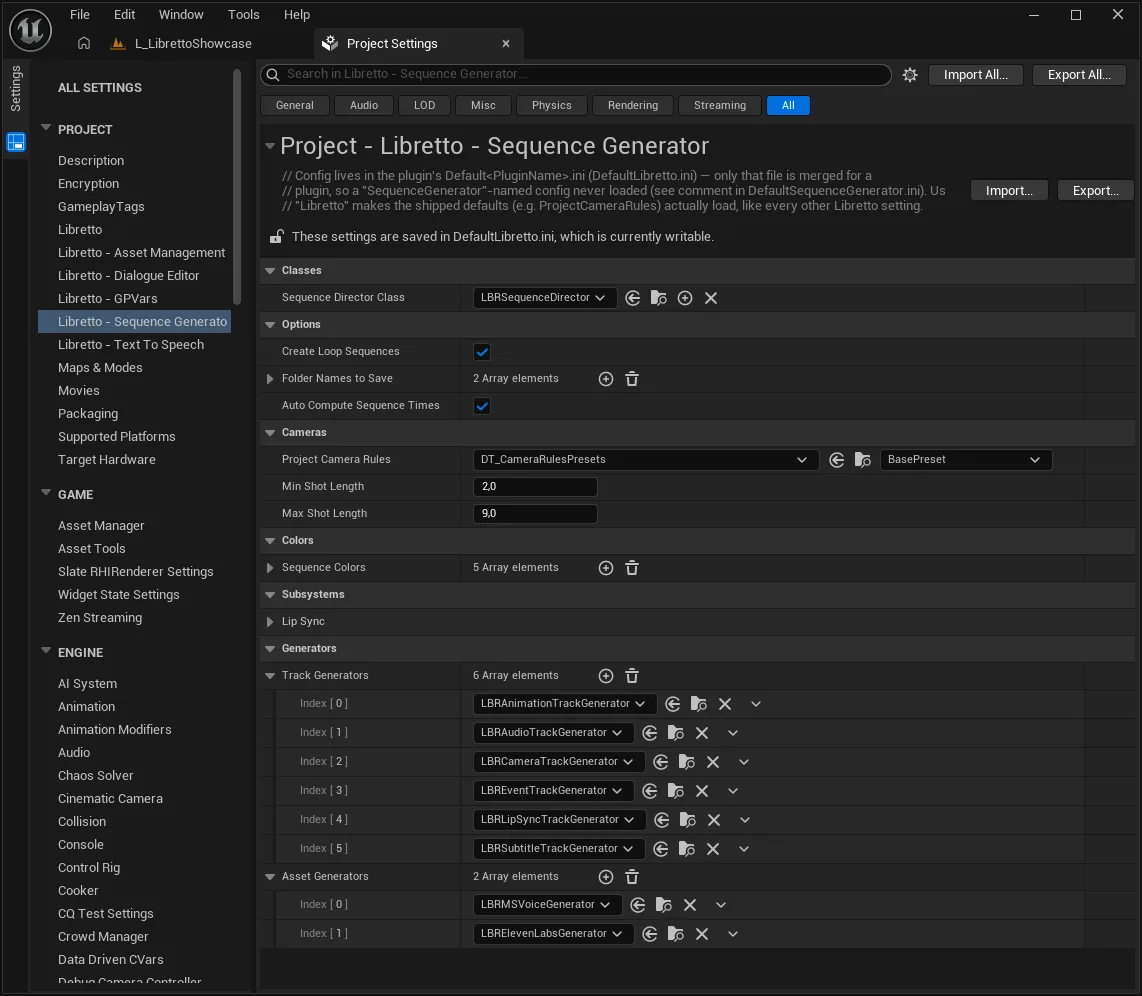
Piège
Une génération complète s'exécute avec Libretto.Generation.Tracks.All coché, ce qui écrase
tous les types de pistes enregistrés — le vôtre inclus — donc vous devez retirer votre
sortie précédente dans CleanSequence ou elle s'empilera. Les pistes placées sous un dossier
de Folder Names To Save (par défaut VFX, Audio) sont épargnées, c'est ainsi que les ajouts
faits à la main survivent à une régénération. Si votre piste consomme un asset tout neuf,
produisez-le dans un asset generator (exécuté avant les pistes).
Voir aussi : Custom Track Generators · Écrire votre propre générateur
Je veux générer un nouveau type d'asset pour mes répliques — un meilleur lip-sync, par exemple
À côté des track generators il y a une seconde liste, antérieure, d'asset generators — ils
produisent les données brutes qu'une piste consomme ensuite (audio TTS, animation de lip-sync…), et
elle est tout aussi ouverte. Sous-classez ULBRAssetGenerator, enregistrez-le, et il s'exécute
dans la passe Generate Assets avant que la moindre piste Sequencer ne soit posée.
- Partez de ce qui est livré. Le lip-sync est un bon exemple : Libretto inclut un générateur
simpliste basé sur l'amplitude,
ULBRAmplitudeLipSyncGenerator, qui bake une animation de morphMouthOpenà partir de l'enveloppe RMS de l'audio — exactement comme MSVoice et ElevenLabs sont livrés pour le TTS. Si vous voulez un lip-sync de qualité phonème/visème, vous remplacez ce seul générateur, pas le pipeline. - Écrivez la classe. Sous-classez
ULBRAssetGeneratoret donnez-lui un leaf tag sousLibretto.Generation.Assets.TypesdepuisGetAssetID(p. ex.…Types.LipSync) pour qu'il puisse être coché seul dans l'assistant Generate Assets. SurchargezInitializeLine(cette réplique a-t-elle besoin de quelque chose ?),GenerateLine(produire l'asset — il doit appelerLineGeneratedune fois terminé) etImportLine(amener le fichier produit dans Unreal ; laissez-le vide si, comme le générateur d'amplitude, vous construisez leUAnimSequenceen mémoire). UtilisezGetDependanciespour déclarer les types d'assets à générer d'abord (une passe de lip-sync a besoin que l'audio existe déjà). - Enregistrez-le dans Project Settings ▸ Libretto – Sequence Generator ▸ Asset Generators.
Il apparaît alors dans la liste Assets to Generate de l'assistant, et le générateur de piste**
correspondant (
LBRLipSyncTrackGenerator) place sa sortie dans la séquence automatiquement.
Piège
La génération d'assets est asynchrone et basée sur le quota — GenerateLine doit signaler la
fin avec LineGenerated, ou la passe se bloque à attendre une réplique qui ne finit jamais.
Et rappelez-vous le partage en deux listes : un asset generator produit la donnée, un
track generator la place — un nouvel asset sans piste pour le référencer est généré mais
n'apparaît jamais dans la séquence.
Voir aussi : Asset generators · Custom Track Generators · LipSync
Je veux échanger le backend audio ou brancher un autre fournisseur TTS
Libretto masque « d'où vient l'audio » et « comment la parole est synthétisée » derrière des classes abstraites — sous-classez la bonne et pointez les réglages vers elle ; le reste du pipeline est intact. C'est exactement ainsi que sont construits l'extension Wwise et les fournisseurs TTS livrés.
- Backend audio — l'abstraite
ULBRAudioAssetmasque la classe audio concrète aux générateurs (par défaut basée surUSoundBase; Wwise fournit sa propre sous-classe, et la base anticipe explicitement des backends comme Wwise ou FMod). Sous-classez-la et réglezAudioAssetClass. - Fournisseur TTS — une sous-classe de
ULBRTTSGenerator, pilotée parULBRTextToSpeechSubsystem, produit l'audio parlé temporaire. MSVoice et ElevenLabs sont livrés ; ajoutez le vôtre pour appeler un synthétiseur différent.
Piège
Ce sont les coutures supportées — vous remplacez une classe et réglez un paramètre, vous ne forkez pas le plugin. Si vous vous retrouvez à éditer les sources de Libretto pour changer l'audio ou la parole, il vous manque presque certainement l'un de ces points d'extension.
Voir aussi : Voix — un fournisseur TTS plus avancé · Wwise — comment ça s'insère dans Libretto · Custom Track Generators
Mon dialogue ne démarre pas (ou se bloque) quand je le déclenche
Presque toujours l'une de trois choses : le personnage n'implémente pas l'interface de dialogue, la requête de démarrage de l'interface ne signale jamais « prêt », ou les corps ne sont pas dans le niveau. Descendez cette liste avant de chercher ailleurs.
- Le personnage doit implémenter
ILBRDialogueCharacter(en Blueprint ou C++, ou utiliser une implémentation toute prête commeALBRSimpleDialogueCharacter). Un pawn qui ne l'implémente pas ne peut pas prendre part à un dialogue. RequestStartDialoguedoit rappelerULBRDialogueManager::OnDialogueCharacterReadyForDialogue. Si votre implémentation personnalisée l'oublie, le dialogue attend éternellement un personnage qui ne se déclare jamais prêt — c'est le symptôme classique « ça se bloque juste au démarrage ».- Les corps doivent déjà être dans le niveau. Sans stage (3C), le générateur se lie au premier
acteur de chaque classe de personnage trouvé dans le monde — si le pawn n'y est pas, il n'y a
personne pour parler. Lancez avec
StartDialogueInstance(ou le bouton Preview pour tester en éditeur).
Piège
Un blocage au démarrage est un problème de readiness, pas de données — n'allez pas reconstruire
l'asset de dialogue. Vérifiez d'abord le callback OnDialogueCharacterReadyForDialogue dans votre
surcharge de RequestStartDialogue.
Voir aussi : Perspective — rendre un personnage capable de parler · Prise en main
La génération s'exécute mais produit une séquence vide (ou partielle)
La cause habituelle est une génération qui n'a pas demandé tous les types de pistes, ou des assets non générés avant les séquences. Les deux sont rapides à vérifier dans l'assistant Generate Sequences.
- Laissez les flags de sous-dialogue cochés. L'assistant génère par défaut tous les
sous-dialogues et tous les types de pistes (
Libretto.Generation.Tracks.All). Si vous avez décoché des choses pour cadrer une passe, une sélection trop étroite peut laisser la séquence vide — relancez avec les valeurs par défaut pour confirmer. - Generate Assets avant Sequences. Le contenu parlé (TTS, lip-sync) est produit par la génération d'assets ; lancez Generate Assets d'abord, puis Generate Sequences, sinon les répliques sortent muettes.
- Attention au contenu verrouillé et préservé. Une sous-séquence que vous avez verrouillée est sautée à la régénération (par conception), et CleanAll vs le clean incrémental par défaut se comportent différemment — voir la FAQ Génération.
Piège
Il n'y a aucune étape « Compile » dans le flux de génération de l'éditeur — si vous en
cherchiez une, vous n'en avez pas besoin. (L'appel compile n'existe que dans le pipeline
d'import CSV headless, pas dans l'UI.)
Voir aussi : Génération · Génération — lancer la génération
Quelque chose cloche — où regarder ?
La plupart des problèmes Libretto ont un endroit précis et connu à vérifier — voici la liste courte, chacune pointant vers l'entrée qui la corrige. Quand quelque chose se comporte mal, commencez ici plutôt que de deviner.
- Les caméras visent un mur, ou la vue rebascule vers le gameplay — le fallback d'occlusion a besoin d'une caméra sœur dégagée, et un stage sans caméra valide produit des coupes vides → Caméras.
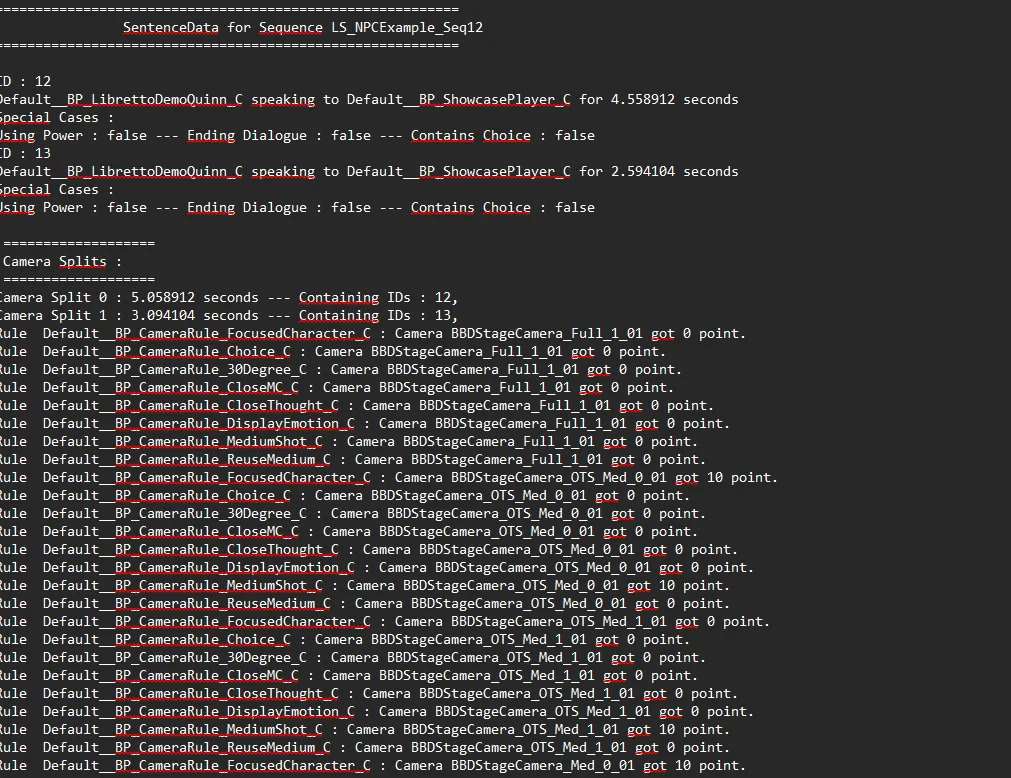
- Un plan filme le mauvais personnage, ou les plans semblent aléatoires — les règles de caméra ne
sont pas câblées ; lisez le journal par dialogue sous
Saved/GenerationLog/Cameras/<Dialogue>.txt→ Caméras. - Les tags de dialogue manquent ou sont désynchronisés (surtout en build packagée) — supprimez le
cache éditeur
Saved/LBRDynamicTags.cachepour forcer une re-scan → Data & logique. - L'enregistrement échoue / pas de vidéo — l'enregistrement est réservé à Windows et exige un dialogue déjà généré ; vérifiez le réglage Output de votre Recording Config → Génération.
- Une génération adossée à Wwise signale de l'audio manquant/de longueur zéro — Wwise n'est pas connecté via WAAPI → l'entrée Wwise ci-dessus.
- Une réplique a changé mais pas sa voix — une passe normale ne génère que ce qui manque ; re-doublez avec le flag Force, cadré par sous-dialogue → Voix.
Piège
Dans le doute, lisez d'abord le journal de génération. La génération écrit son raisonnement
par dialogue sous Saved/GenerationLog/… — il vous dit généralement pourquoi un plan, une
réplique ou une piste est sorti tel quel, ce qui est plus rapide que de relancer à l'aveugle.
Voir aussi : Aperçu How-to & FAQ · Caméras · Data & logique · Voix · Génération