Synthèse vocale (TTS)
La synthèse vocale génère automatiquement l'audio parlé des répliques d'un dialogue, ce qui vous permet d'entendre un dialogue se dérouler avant même qu'un comédien ne soit enregistré. Elle ne remplace pas la voix enregistrée : c'est un substitut rapide et peu coûteux qui vous laisse relire le rythme, la mise en scène et les caméras avec un vrai son dans la séquence.
La TTS s'exécute comme un générateur d'assets pendant la génération :
les générateurs d'assets s'exécutent avant les générateurs de pistes, et l'audio qu'ils produisent
est ensuite consommé par le LBRAudioTrackGenerator lorsqu'il remplit la piste audio. Consultez la
vue d'ensemble de la génération pour savoir où se situe la TTS dans le
pipeline et où l'audio est écrit.
Ce qui reçoit une voix
La TTS n'est générée que pour les répliques de type Text, et uniquement lorsque la réplique
possède un Speaker. Dans le code, le générateur ignore toute réplique dont le type n'est pas
Text ou qui n'a pas de locuteur
(Dialogue->Types[Index] != ELBRLineType::Text || !Dialogue->Speakers[Index]).
Donner une voix au joueur
Les réponses du joueur sont écrites sous forme de répliques Reply, et les Replies ne
reçoivent aucune TTS. Pour donner une voix au joueur, ajoutez de vraies répliques Text
prononcées par le personnage joueur (par exemple à l'intérieur d'un Choice, ou juste après) :
ce sont les seules répliques du joueur qui produisent de l'audio.
L'audio déjà généré n'est pas reconstruit lors d'une exécution normale ; activez le drapeau Force sur la génération d'assets pour écraser un audio obsolète après avoir modifié le texte d'un dialogue (voir Running generation).
Sortie sensible au point de montage
L'emplacement où atterrit l'audio est géré par le pipeline de génération, pas par les
fournisseurs : la sortie est sensible au point de montage, de sorte qu'un dialogue livré dans
un plugin génère sa TTS à côté de ses séquences dans ce plugin plutôt que dans /Game.
Reportez-vous à la note sur la sortie sensible au point de
montage plutôt que de la répéter ici.
Les fournisseurs en un coup d'œil
Libretto est livré avec deux fournisseurs fonctionnels.
| Fournisseur | Où il s'exécute | Réseau | Coût | Qualité de voix | Configuration |
|---|---|---|---|---|---|
| MSVoice | Local (API vocale Windows, SAPI) | Aucun | Gratuit | Basique, robotique | Aucune — livré préconfiguré dans le .ini du plugin |
| ElevenLabs | Cloud (API ElevenLabs) | Requis | Payant (quota API) | Élevée, naturelle | Jeton d'API + une DataTable personnage→voix |
Le fournisseur actif est simplement celui dont vous cochez le générateur d'assets TTS dans le
wizard Generate Assets. LBRMSVoiceGenerator et LBRElevenLabsGenerator sont tous deux enregistrés par
défaut dans la liste des Asset Generators.
Réglages
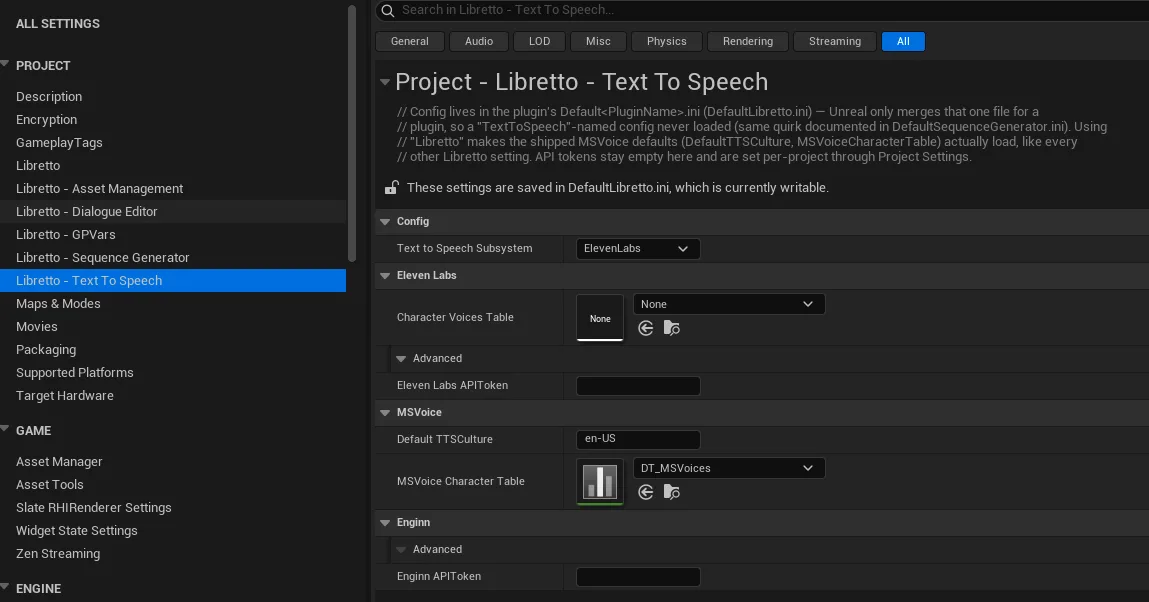
Toute la configuration de la TTS se trouve dans Project Settings ▸ Libretto – Text To Speech
(ULBRTextToSpeechSettings) :
| Réglage | Section | Rôle |
|---|---|---|
| Text To Speech Subsystem | Config | Nom du sous-système TTS à utiliser (choisi parmi les options installées). |
| ElevenLabs API Token | ElevenLabs | Jeton pour l'API ElevenLabs — requis pour consommer votre propre quota de personnages. |
| Character Voices Table | ElevenLabs | DataTable associant chaque personnage à une voix ElevenLabs. |
| Default TTS Culture | MSVoice | Langue / locale par défaut (p. ex. en-US) utilisée lorsqu'une ligne de personnage n'en spécifie aucune — pilote à la fois le choix de la voix et la langue parlée. Vaut en-US par défaut. |
| MSVoice Character Table | MSVoice | DataTable (lignes de FLBRMSVoiceCharacterDesc) associant chaque personnage à une voix Windows / langue / prosodie. |
Les valeurs par défaut sont livrées dans le .ini du plugin
ULBRTextToSpeechSettings utilise Config = "Libretto", si bien que ses valeurs par défaut
livrées résident dans le DefaultLibretto.ini du plugin (Unreal ne fusionne que ce seul
fichier de configuration pour un plugin, un fichier de config nommé TextToSpeech ne serait donc
jamais chargé). Le plugin est livré avec :
[/Script/LBRTextToSpeechEditor.LBRTextToSpeechSettings]
DefaultTTSCulture=en-US
MSVoiceCharacterTable=/Libretto/Examples/Characters/DT_MSVoices.DT_MSVoices
MSVoiceCharacterTable pointe vers du contenu d'exemple livré avec le plugin sous forme de
référence faible. Les jetons d'API restent vides dans le .ini — renseignez-les par projet
via Project Settings.
MSVoice — voix Windows locales
ULBRMSVoiceGenerator produit de l'audio avec l'API vocale Windows (SAPI 5, appelée dans le processus). Il est local et
gratuit, ne nécessite aucun réseau et fonctionne immédiatement — ce qui en fait le choix par défaut
naturel pour l'itération au quotidien.
Comment une voix est choisie
Pour chaque réplique Text, MSVoice détermine la voix, la langue et la prosodie du locuteur, puis
construit un document SSML et le synthétise :
- Si le locuteur possède une ligne dans la MSVoice Character Table, ce sont la voix / la culture / la prosodie de cette ligne qui sont utilisées.
- Sinon, le générateur choisit automatiquement une voix d'après le genre du personnage — lu depuis
l'interface
LBRDialogueCharacterviaILBRDialogueCharacter::LBRGetCharacterGender— combiné à la culture. Cela reste parfaitement valide : la langue est correcte, simplement sans voix ni prosodie explicites.
Le SSML qu'il construit ressemble à ceci (un choix automatique selon le genre, puis une voix explicite par son nom) :
<speak version="1.0" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  <voice gender="male" xml:lang="en-US">
    <prosody pitch="-20%" rate="-6%">Your line text here.</prosody>
  </voice>
</speak>
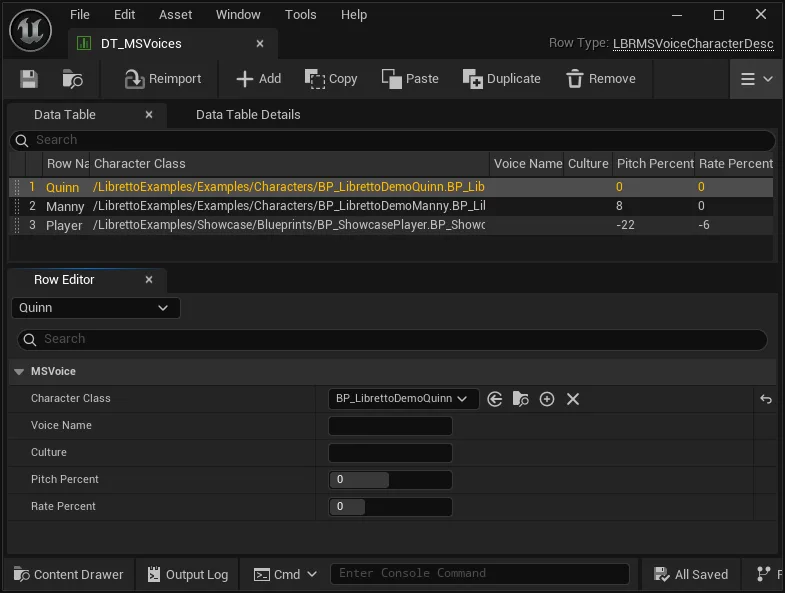
La table de personnages (DT_MSVoices)
Chaque ligne de la table MSVoice est un FLBRMSVoiceCharacterDesc :
| Champ | Rôle |
|---|---|
| Character Class | Le personnage de dialogue auquel s'applique cette ligne. |
| Voice Name | Une voix Windows installée explicite (p. ex. Microsoft David Desktop). Laissez vide pour choisir automatiquement la meilleure voix installée selon le genre + la culture du personnage — portable d'une machine à l'autre. |
| Culture | Langue / locale de la voix (p. ex. en-US, fr-FR). Vide, elle retombe sur Default TTS Culture. |
| Pitch Percent | Décalage de hauteur relatif, en pourcentage (p. ex. -20 = plus grave). Borné à −100…100. |
| Rate Percent | Décalage du débit de parole, en pourcentage (p. ex. -6 = plus lent). Borné à −90…200. |
Laissez la culture suivre la culture de génération
Laissez la Culture d'une ligne vide pour que la voix suive la culture de génération (via Default TTS Culture). La renseigner fige ce personnage sur une langue précise, quelle que soit la culture avec laquelle vous générez — utile pour un personnage parlant une langue étrangère, inutile sinon.
Deux personnages, une seule voix, distingués par la prosodie
Une machine type ne dispose que de deux voix SAPI anglaises (en-US) installées (David et Zira). Deux personnages masculins en-US sont donc tous deux associés à David. Différenciez-les grâce au Pitch Percent et au Rate Percent : donnez à l'un une hauteur plus grave et/ou un débit différent afin que les deux soient distinguables à l'oreille même s'ils partagent la même voix sous-jacente.
Installer davantage de voix
La disponibilité des voix dépend des packs de langue / de synthèse vocale Windows installés sur la machine. Si vous n'avez que deux voix, installez des voix SAPI supplémentaires via Settings ▸ Time & Language ▸ Speech de Windows pour élargir le vivier dans lequel le choix automatique peut puiser.
ElevenLabs — cloud, haute qualité
ULBRElevenLabsGenerator appelle l'API cloud ElevenLabs. Il produit l'audio le plus naturel des
trois, au prix d'une connexion réseau et d'un quota payant.
Pour l'utiliser :
- Renseignez votre ElevenLabs API Token dans les réglages TTS.
- Définissez la Character Voices Table — une DataTable associant chaque personnage à une voix ElevenLabs et à ses réglages de voix (stability, similarity, speed, style, speaker boost).
Type de ligne ElevenLabs
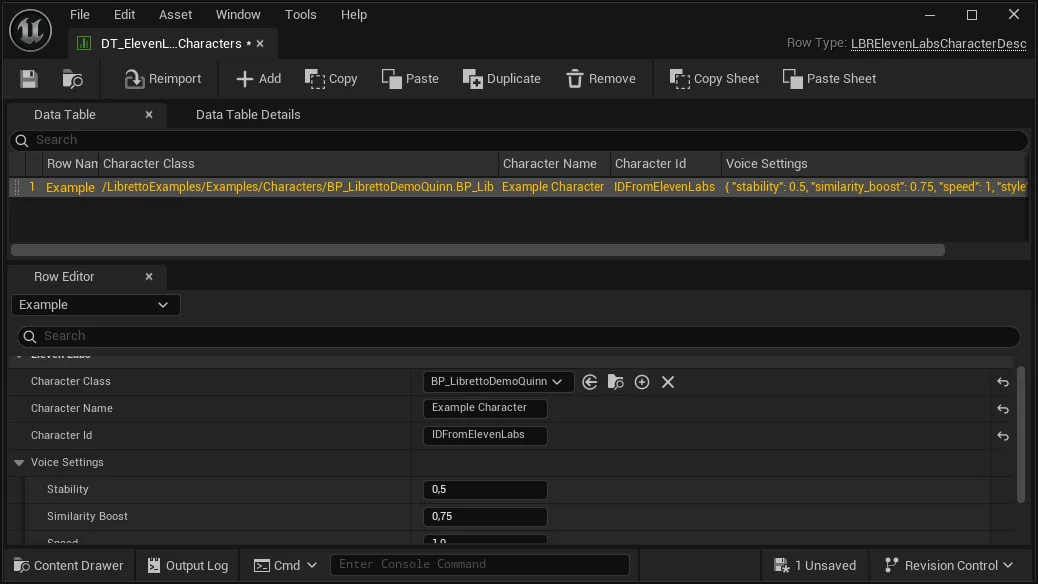
La Character Voices Table est une DataTable dont la structure de ligne est
FLBRElevenLabsCharacterDesc — elle associe une classe de personnage à un nom, un identifiant
de voix et un FLBRElevenLabsVoiceSettings embarqué (les paramètres de voix). Créez votre table
avec ce type de ligne.
Quota et coût
Chaque réplique générée consomme du quota ElevenLabs. Comme un dialogue complet régénère de nombreuses répliques, préférez ne générer que ce dont vous avez besoin (sélection par sous-dialogue, et fiez-vous au comportement ignorer ce qui est déjà généré plutôt qu'à Force). La TTS rend en outre la génération nettement plus lente — voir l'avertissement sur la page de vue d'ensemble.